ModelRouter
Orquestación multi-proveedor LLM e infraestructura backend
API asíncrona para orquestar múltiples proveedores LLM mediante una interfaz unificada, con streaming, fallback automático, control de disponibilidad y observabilidad.
1. Resumen
ModelRouter es una API HTTP asíncrona construida con Python y FastAPI que proporciona una interfaz unificada para interactuar con múltiples proveedores de Large Language Models.
El proyecto abstrae las diferencias entre proveedores mediante adaptadores independientes y añade mecanismos de fallback, streaming, control de disponibilidad y estado compartido mediante Redis.
Actualmente integra cinco proveedores:
- Groq
- OpenRouter
- OpenAI
- Gemini
- Ollama
El proyecto se encuentra en estado experimental / desarrollo activo y está orientado principalmente a explorar patrones de arquitectura backend para infraestructura basada en LLM.
2. Problema
Integrar varios proveedores LLM directamente dentro de una aplicación obliga a gestionar diferentes:
- APIs y formatos de solicitud.
- Mecanismos de autenticación.
- Modelos y capacidades.
- Formatos de respuesta.
- Errores y condiciones de disponibilidad.
- Mecanismos de streaming.
Esto aumenta el acoplamiento entre la aplicación y los proveedores externos y hace más costoso incorporar nuevos proveedores o cambiar la estrategia de disponibilidad.
ModelRouter aborda este problema mediante una capa intermedia que proporciona un contrato común para los consumidores de la API.
3. Solución
ModelRouter introduce una capa de orquestación entre el cliente y los proveedores LLM.
La arquitectura separa:
- API HTTP.
- Validación y serialización.
- Orquestación.
- Decisiones de enrutamiento.
- Adaptadores de proveedores.
- Cliente HTTP.
- Estado temporal compartido.
- Observabilidad.
El cliente interactúa con un único contrato mientras ModelRouter decide qué proveedor utilizar y cómo manejar determinados fallos de disponibilidad.
Flujo principal
Cliente
   │
   ▼
FastAPI
   │
   ▼
Controller
   │
   ▼
Orchestrator
   │
   ▼
Router
   │
   ├── Proveedor A
   ├── Proveedor B
   ├── Proveedor C
   └── ...
        │
        ▼
   API LLM externa
        │
        ▼
   Respuesta / Streaming
4. Arquitectura
ModelRouter utiliza una arquitectura por capas para separar las responsabilidades de la API, la lógica de orquestación y las integraciones externas.
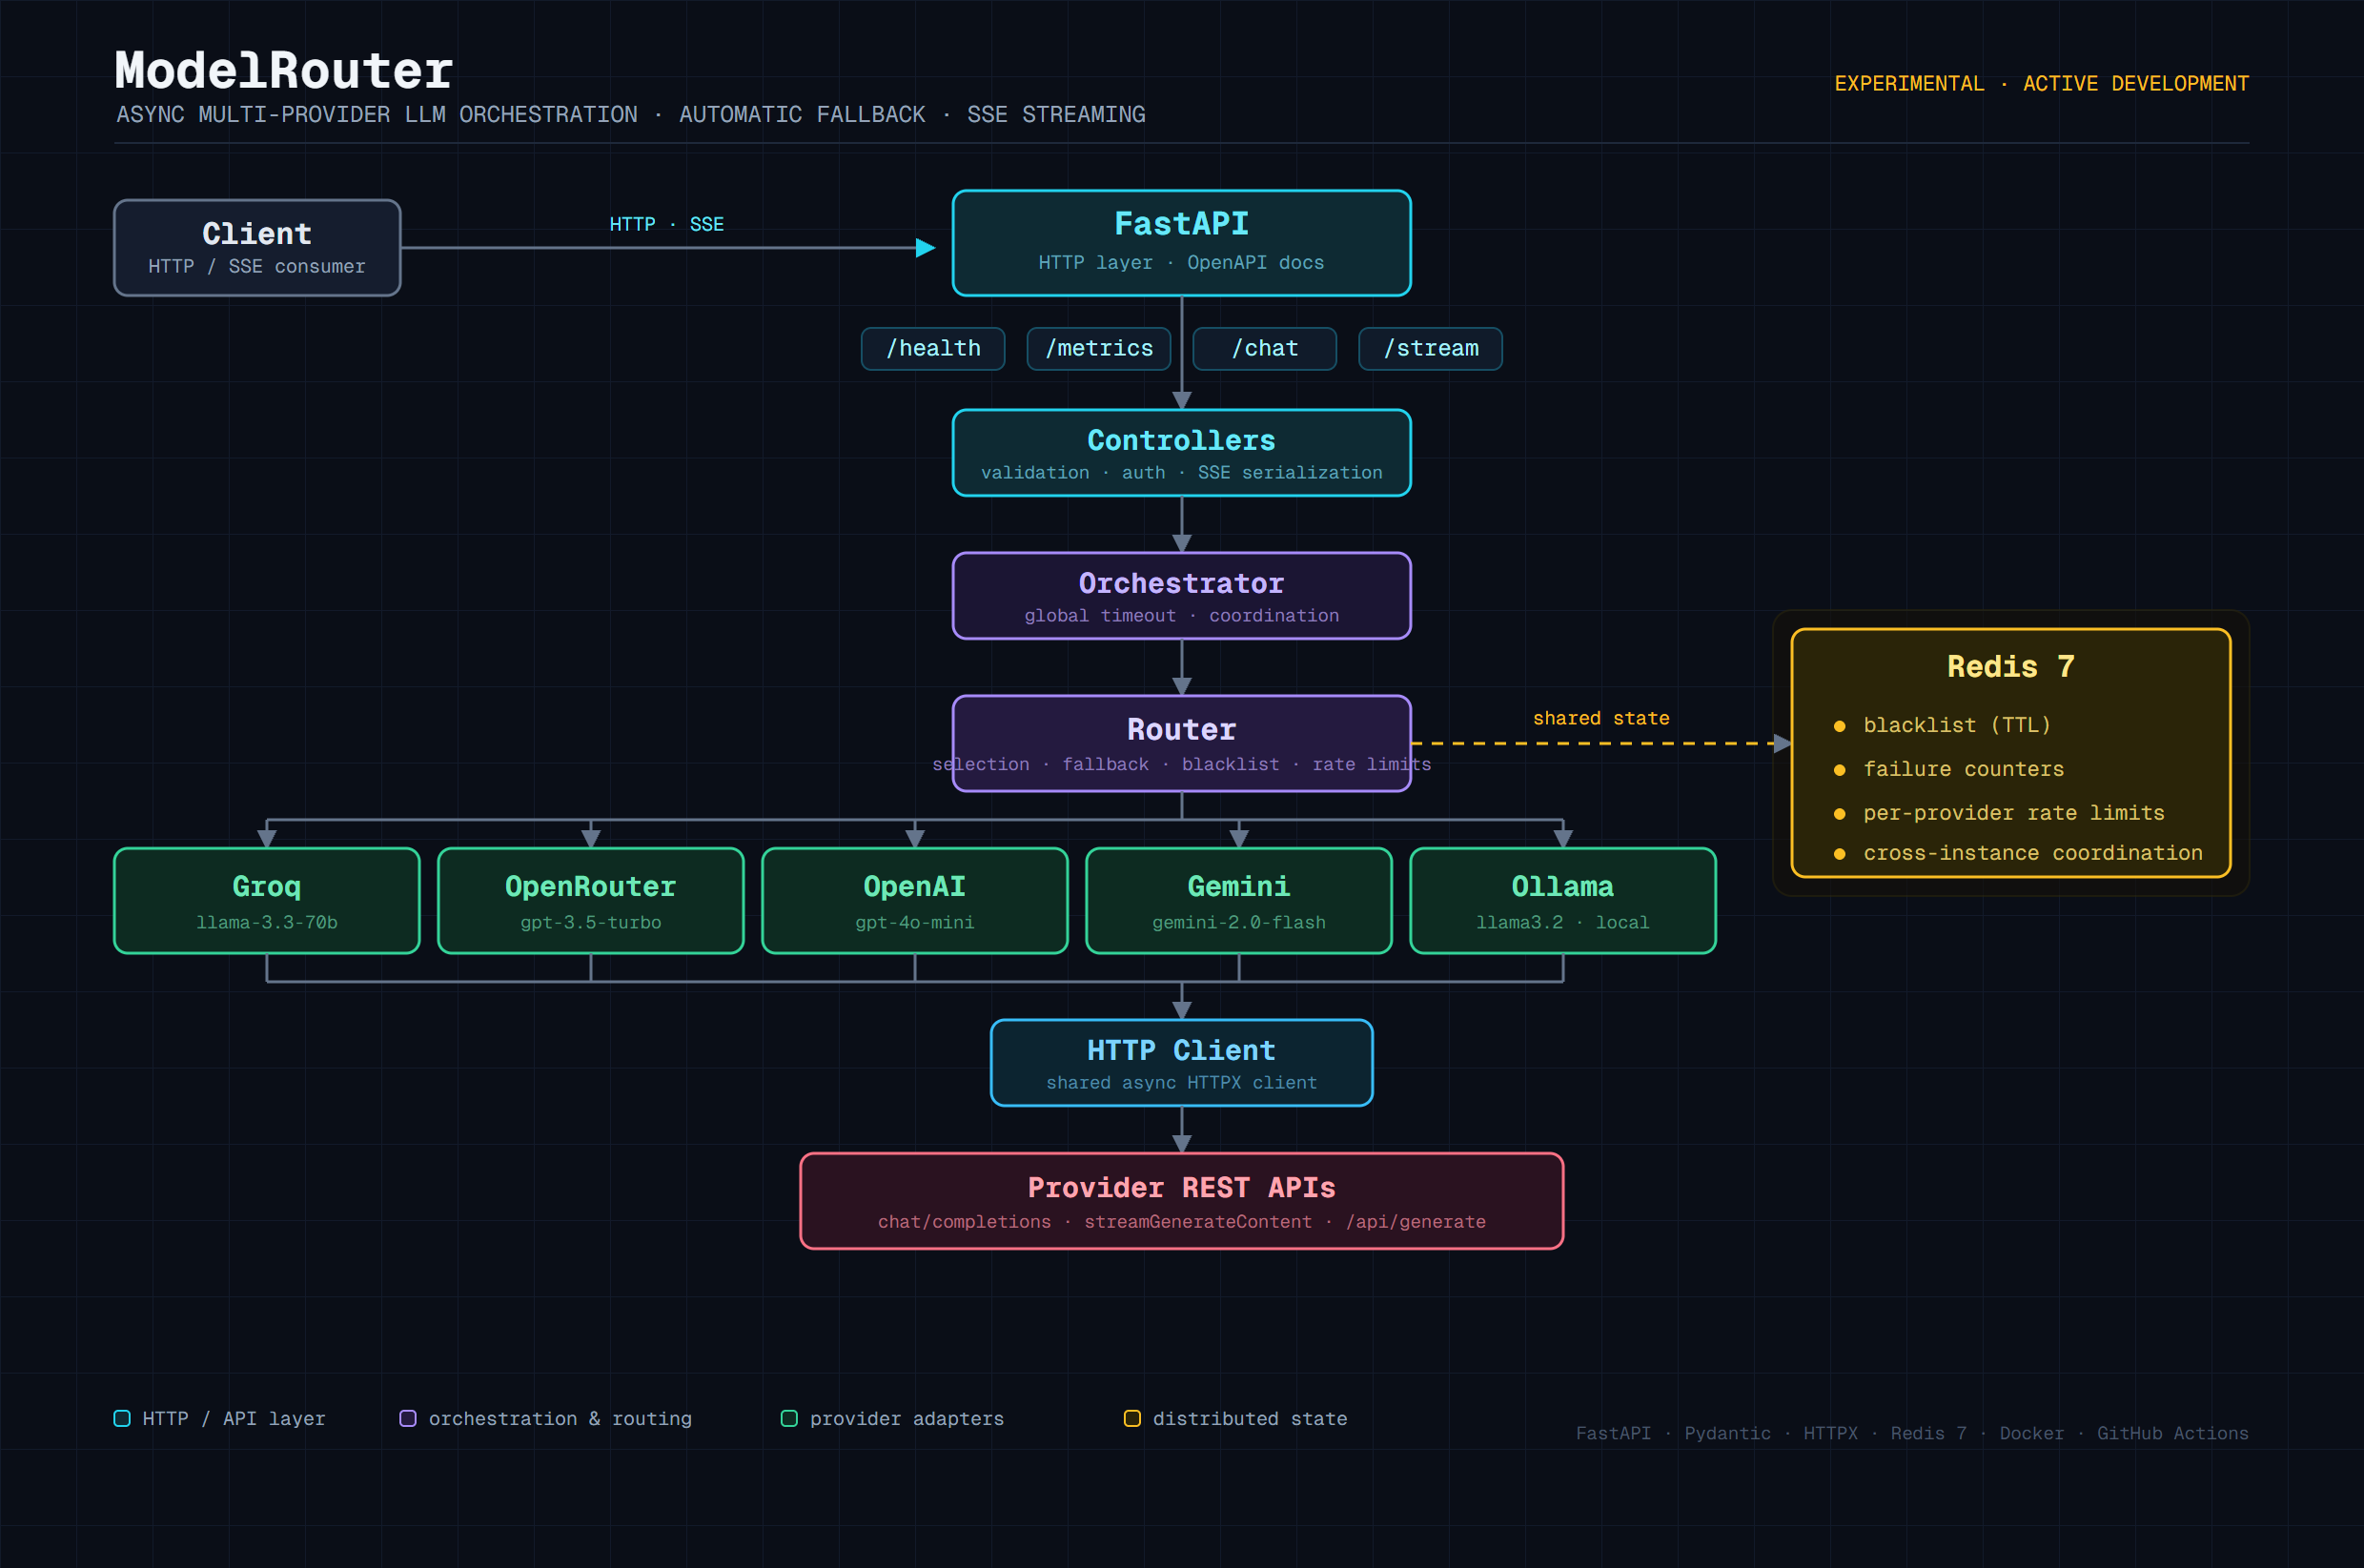
Arquitectura representativa mostrando la interacción entre API, orquestador, router, adaptadores de proveedores, cliente HTTP y Redis.
Capas principales
- API: FastAPI y documentación OpenAPI.
- Controller: validación de solicitudes y construcción de respuestas.
- Orquestación: coordinación de ejecución, timeouts y flujo de solicitudes.
- Enrutamiento: selección de proveedores, disponibilidad y fallback.
- Proveedores: adaptadores independientes para cada API LLM.
- Infraestructura: HTTPX, Redis y componentes compartidos.
- Observabilidad: logging estructurado, métricas y health checks.
La separación entre router y adaptadores permite modificar las políticas de selección sin acoplarlas a las implementaciones específicas de cada proveedor.
5. Capacidades implementadas
Orquestación multi-proveedor
- Interfaz unificada para cinco proveedores LLM.
- Adaptadores independientes por proveedor.
- Normalización de solicitudes y respuestas.
- Aislamiento de diferencias específicas de cada API.
Fallback y disponibilidad
- Selección de proveedor basada en disponibilidad.
- Bloqueo temporal de proveedores que presentan fallos.
- Backoff exponencial para reintentos.
- Estrategia AIMD para ajustar el comportamiento de disponibilidad.
Streaming
- Server-Sent Events (SSE).
- Entrega incremental de respuestas.
- Señalización de finalización del stream.
- Manejo asíncrono de conexiones.
API
GET /health— estado del servicio.GET /metrics— métricas compatibles con Prometheus.POST /chat— generación de respuestas sin streaming.POST /stream— generación mediante streaming SSE.
Estado compartido
Redis se utiliza para mantener información temporal relacionada con:
- Fallos de proveedores.
- Bloqueos temporales.
- Contadores.
- Estado utilizado por mecanismos de disponibilidad.
- Coordinación entre instancias.
Observabilidad
- Logging estructurado en JSON.
- Correlación mediante
request_id. - Métricas compatibles con Prometheus.
- Health checks.
6. Stack tecnológico
| Tecnología | Propósito |
|---|---|
| Python 3.11+ | Runtime |
| FastAPI | API HTTP asíncrona |
| Pydantic | Validación y modelos de datos |
| HTTPX | Cliente HTTP asíncrono |
| Redis 7 | Estado temporal compartido |
| pytest | Testing |
| Black | Formateo |
| Flake8 | Linting |
| MyPy | Verificación estática de tipos |
| pre-commit | Automatización de hooks |
| Docker | Containerización |
| Docker Compose | Desarrollo local |
| GitHub Actions | CI/CD |
| Trivy | Escaneo de imágenes Docker |
Proveedores integrados
| Proveedor | Integración |
|---|---|
| Groq | Adaptador de API |
| OpenRouter | Adaptador de API |
| OpenAI | Adaptador de API |
| Gemini | Adaptador de API |
| Ollama | Adaptador local |
7. Decisiones técnicas relevantes
Patrón Adapter
Cada proveedor se implementa mediante un adaptador independiente.
Ventaja: reduce el acoplamiento con APIs externas y permite incorporar nuevos proveedores sin modificar directamente la lógica de orquestación.
Trade-off: cada integración requiere mantener y probar una implementación específica.
Router separado de los proveedores
La selección de proveedor y las políticas de fallback están separadas de los adaptadores.
Ventaja: las políticas de disponibilidad pueden evolucionar sin modificar las integraciones externas.
Trade-off: introduce una capa adicional de lógica de decisión.
Estado compartido mediante Redis
El estado temporal de disponibilidad se mantiene fuera del proceso principal.
Ventaja: permite compartir determinados estados entre múltiples instancias del servicio.
Trade-off: introduce una dependencia externa y requiere gestionar la disponibilidad de Redis.
Arquitectura asíncrona
FastAPI y HTTPX permiten manejar solicitudes concurrentes y streaming sin bloquear el flujo principal.
Ventaja: adecuada para un servicio que permanece esperando respuestas de proveedores externos.
Trade-off: exige un manejo cuidadoso de errores, timeouts y cancelación en código asíncrono.
8. Seguridad
Mecanismos implementados
- Autenticación mediante API key.
- Validación de entradas mediante Pydantic.
- Gestión de credenciales mediante variables de entorno.
- Sanitización de información sensible en logs.
- Escaneo de imágenes Docker mediante Trivy.
Limitaciones actuales
ModelRouter no se presenta como un gateway LLM endurecido para producción.
Actualmente:
- La autenticación es básica.
- No existe control de acceso multiusuario.
- No existe configuración CORS específica.
- No existe un sistema propio de rate limiting independiente de los límites de los proveedores.
- No existe firma o verificación criptográfica de solicitudes.
- No existe un sistema completo de auditoría.
Estas limitaciones son parte del estado experimental actual del proyecto.
9. Testing y calidad
El proyecto incluye una suite automatizada orientada a validar la lógica de orquestación, adaptadores y componentes principales.
Métricas observables
- 14 archivos de test.
- 61 tests.
- Tests unitarios y de integración.
- Mocking de adaptadores de proveedores.
- Verificación estática de tipos.
- Linting y formateo automatizados.
- Builds de imágenes Docker.
- Escaneo de seguridad en CI.
Pipeline
Calidad
   ├── Black
   ├── Flake8
   └── MyPy

Tests
   └── pytest

Build
   ├── Docker
   └── Trivy
Estas métricas reflejan el nivel de automatización y control de calidad del proyecto, pero no deben interpretarse como una garantía de comportamiento correcto frente a todos los proveedores externos.
10. Interfaz y experiencia del desarrollador
Aunque ModelRouter es principalmente un backend, se ha diseñado una interfaz orientada a facilitar su integración.
API
- Swagger UI en
/docs. - Especificación OpenAPI.
- Respuestas JSON estructuradas.
- Streaming mediante SSE.
- IDs de correlación.
- Health checks.
- Endpoint de métricas.
Desarrollo local
- Configuración mediante variables de entorno.
- Docker Compose.
- Dependencias externas claramente definidas.
- Estructura modular del código.
El objetivo es que una aplicación cliente pueda integrarse con ModelRouter sin conocer los detalles específicos de cada proveedor LLM.
11. Evidencia visual
Streaming
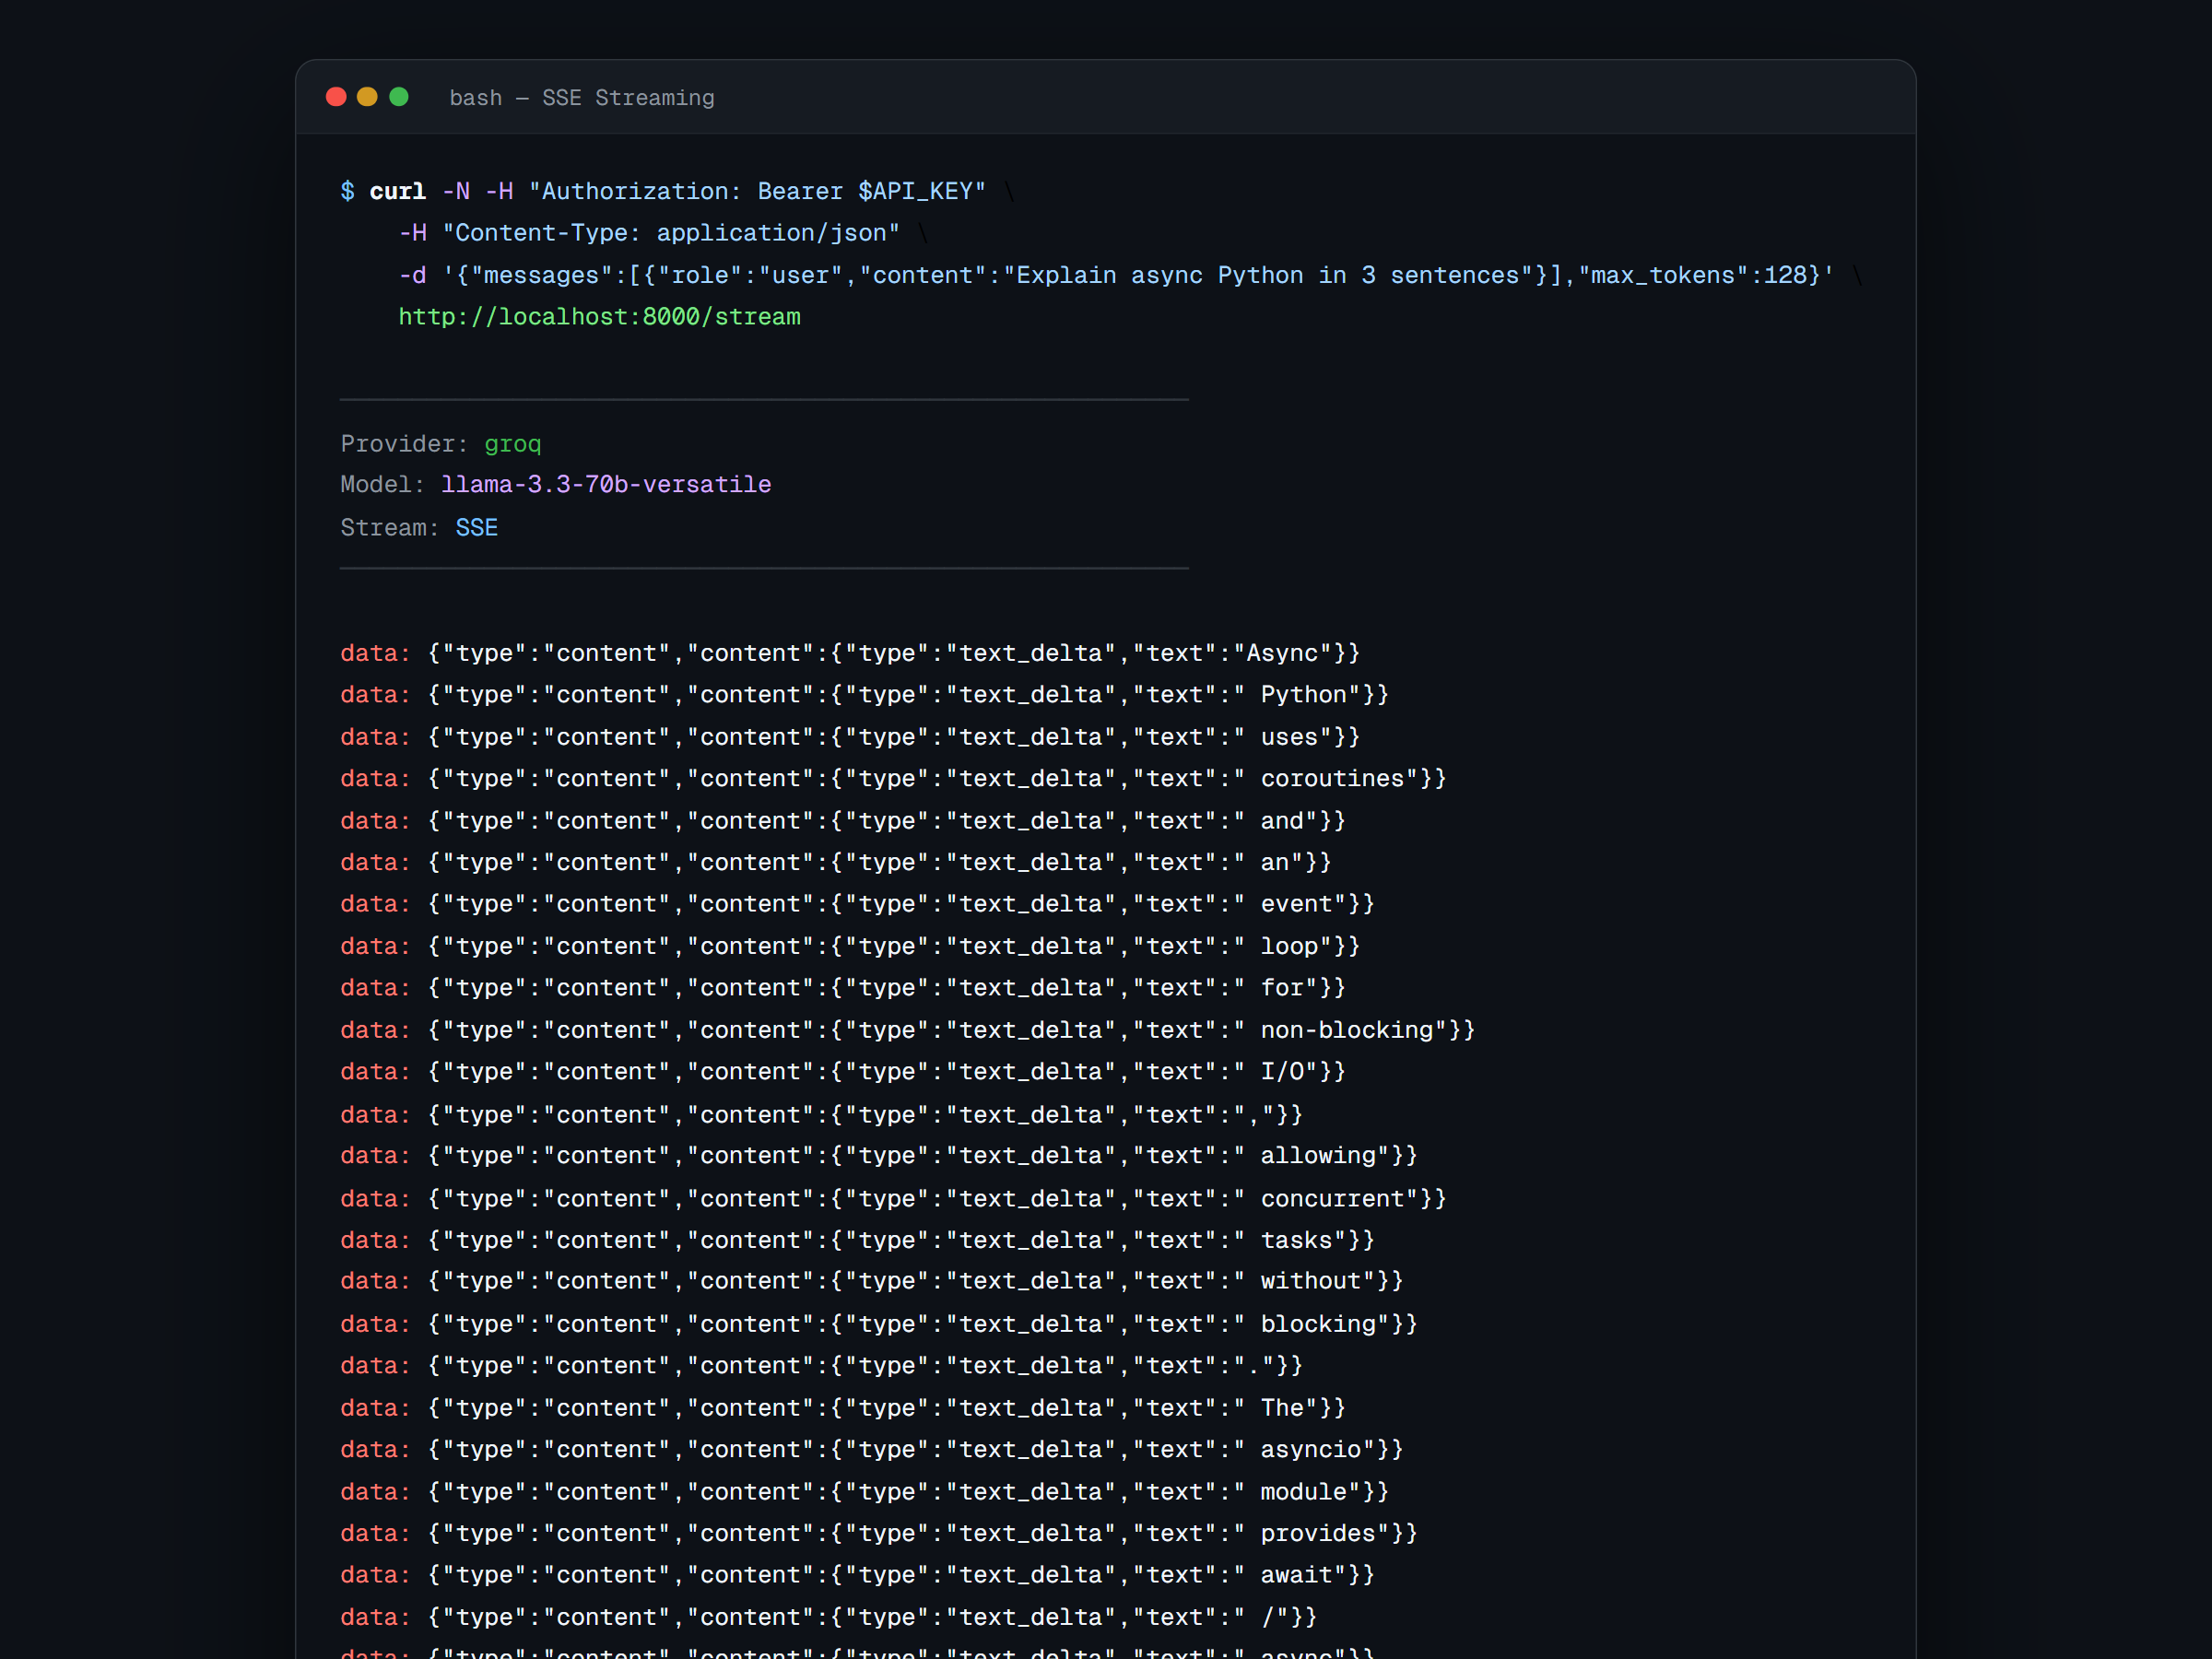
Respuesta incremental entregada mediante Server-Sent Events.
API
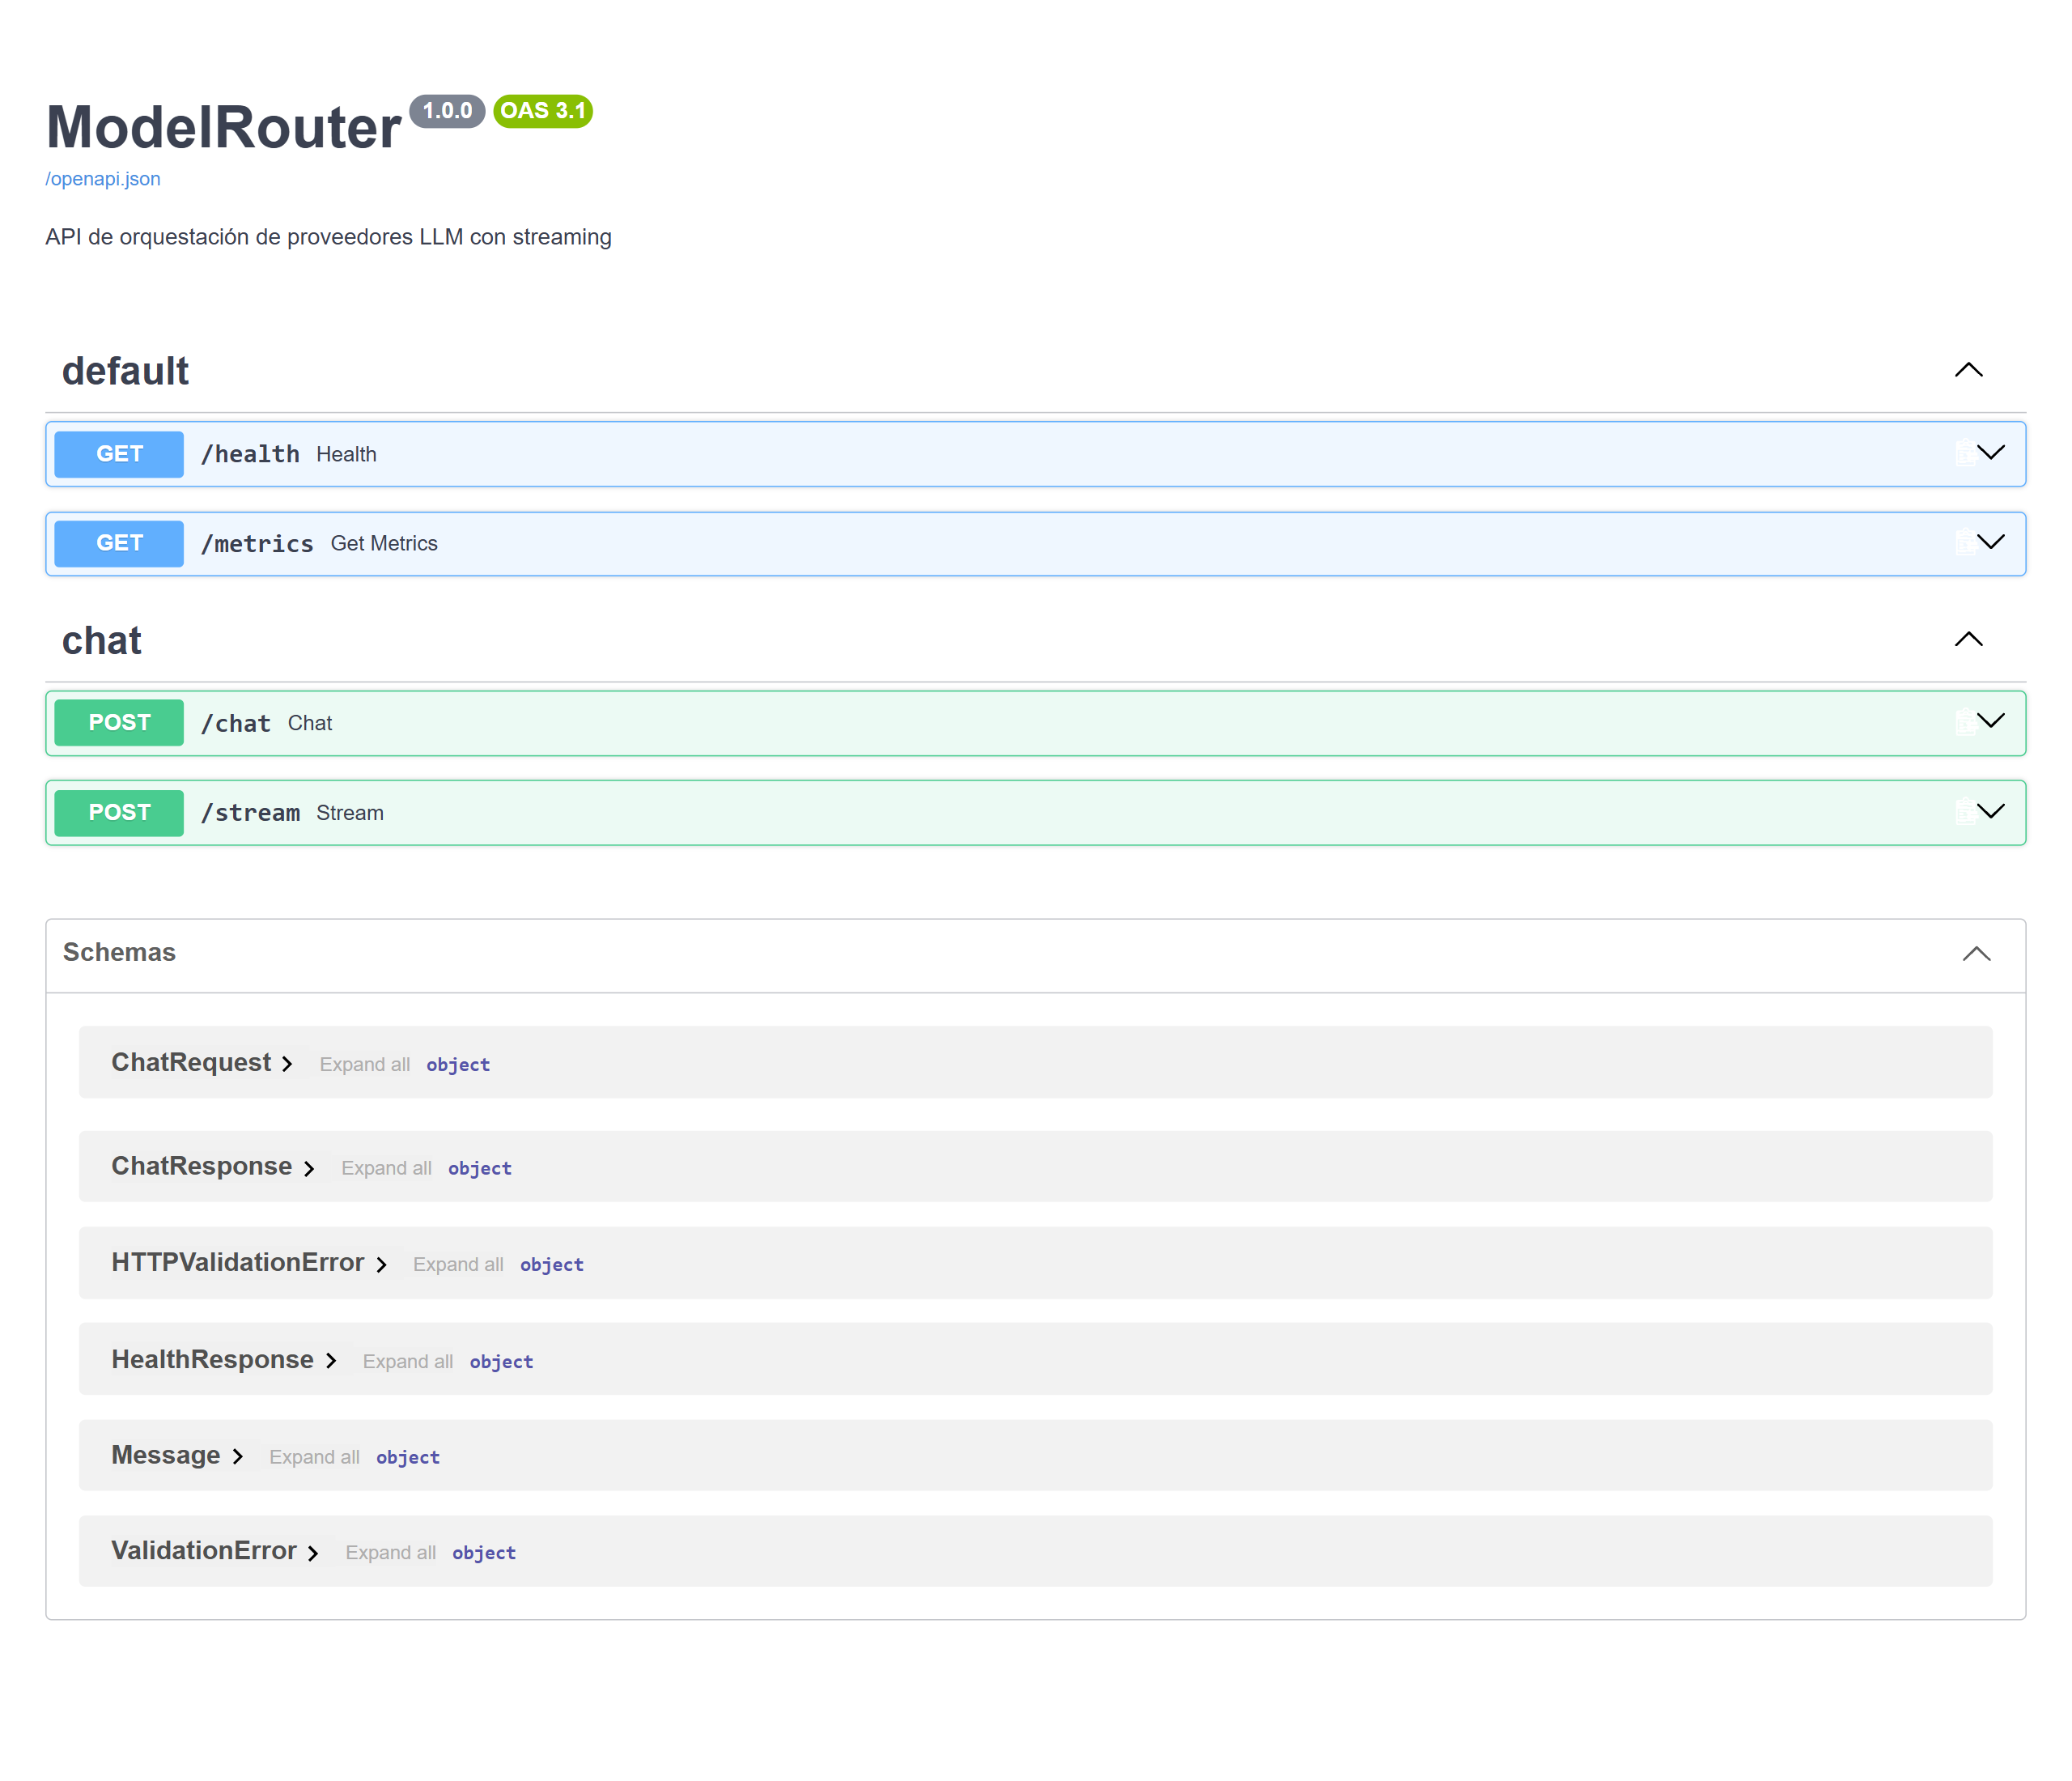
Documentación interactiva generada mediante Swagger/OpenAPI.
Observabilidad
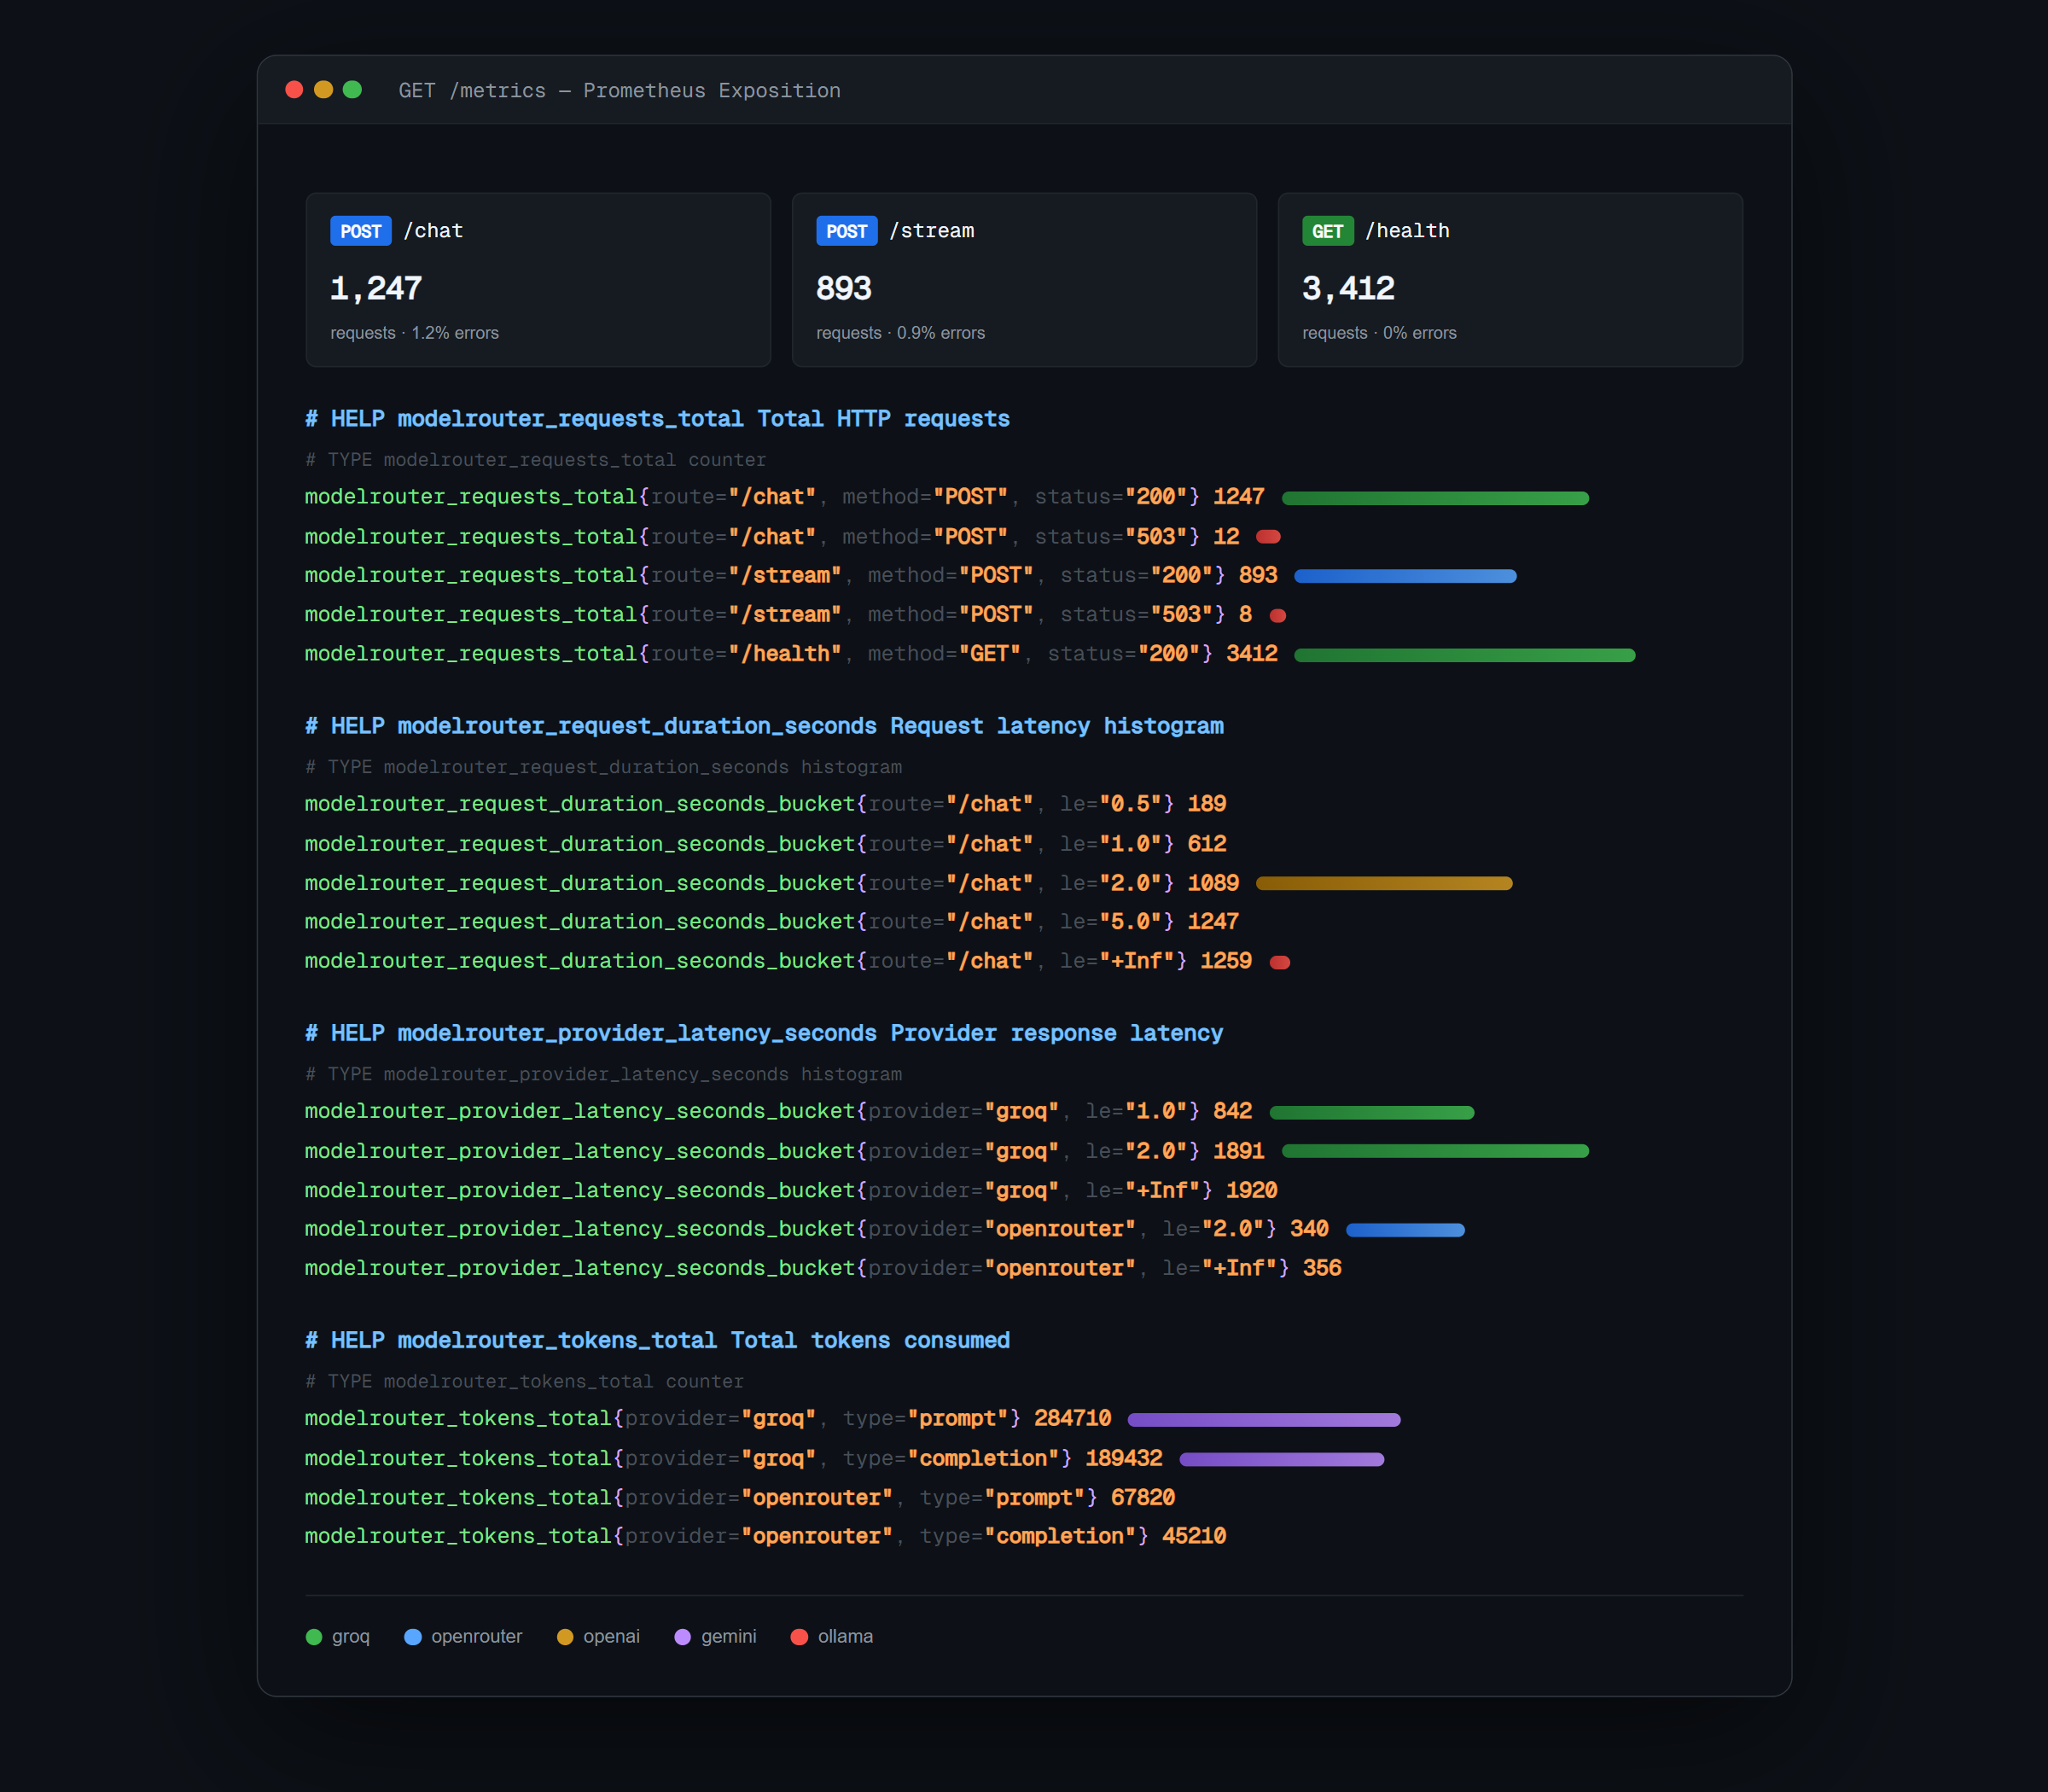
Métricas expuestas mediante el endpoint compatible con Prometheus.
12. Estado y limitaciones
Estado actual: Experimental / Desarrollo Activo
ModelRouter es principalmente una exploración de arquitectura e infraestructura backend para aplicaciones basadas en LLM.
Actualmente no incluye:
- Persistencia de conversaciones.
- Base de datos relacional.
- Interfaz frontend.
- Tests end-to-end contra proveedores reales.
- Gestión avanzada de usuarios y credenciales.
- Control de acceso multiusuario.
- Rate limiting propio.
- Logging de auditoría.
- Tracing distribuido.
Estas limitaciones delimitan el alcance actual del proyecto y evitan presentarlo como un gateway LLM listo para producción.
13. Evolución y competencias demostradas
Evolución futura
Las posibles líneas de evolución incluyen:
- Persistencia de conversaciones con PostgreSQL.
- Incorporación de nuevos proveedores LLM.
- Dashboard de observabilidad con Grafana.
- Métricas más detalladas por proveedor.
- Gestión avanzada de credenciales.
- Autenticación y autorización multiusuario.
- Testing de integración y end-to-end.
- Rate limiting configurable.
- Logging de auditoría.
- Tracing distribuido.
Qué demuestra este proyecto
ModelRouter demuestra experiencia práctica en:
- Desarrollo backend asíncrono.
- FastAPI y diseño de APIs REST.
- Integración de múltiples proveedores LLM.
- Server-Sent Events.
- Patrón Adapter.
- Estrategias de fallback y resiliencia.
- Gestión de estado compartido con Redis.
- Observabilidad con Prometheus.
- Containerización con Docker.
- CI/CD con GitHub Actions.
- Testing automatizado.
- Análisis estático y calidad de código.
- Diseño de infraestructura desacoplada.
El principal valor técnico del proyecto está en la separación entre proveedores, políticas de enrutamiento y capa de transporte, permitiendo experimentar con diferentes estrategias de disponibilidad sin acoplar la aplicación a una API LLM concreta.