LexGuard
Detección de datos sensibles en texto
Proof of concept en Python para detectar posibles datos personales en texto mediante reglas y análisis determinista.
1. Resumen
LexGuard es una prueba de concepto en Python para explorar la detección automática de posibles datos personales (PII) dentro de texto.
El proyecto implementa un flujo de análisis determinista basado en reglas y patrones predefinidos. Su objetivo no es proporcionar un sistema completo de protección de datos, sino validar una aproximación programática al problema y explorar una arquitectura extensible para futuras herramientas de privacidad y seguridad.
2. Contexto / Problema
Los datos personales pueden aparecer accidentalmente en documentos, archivos de texto o entradas de sistemas. La identificación manual de estos datos resulta poco escalable y dificulta incorporar controles de privacidad durante las primeras etapas del procesamiento.
LexGuard explora cómo automatizar una primera capa de identificación mediante reglas deterministas que puedan analizar texto y señalar posibles coincidencias para posterior revisión.
El proyecto parte de una premisa importante: detectar patrones no equivale a comprender el contexto. Por ello, sus resultados deben considerarse indicadores y no decisiones definitivas sobre la presencia de información personal.
3. Solución
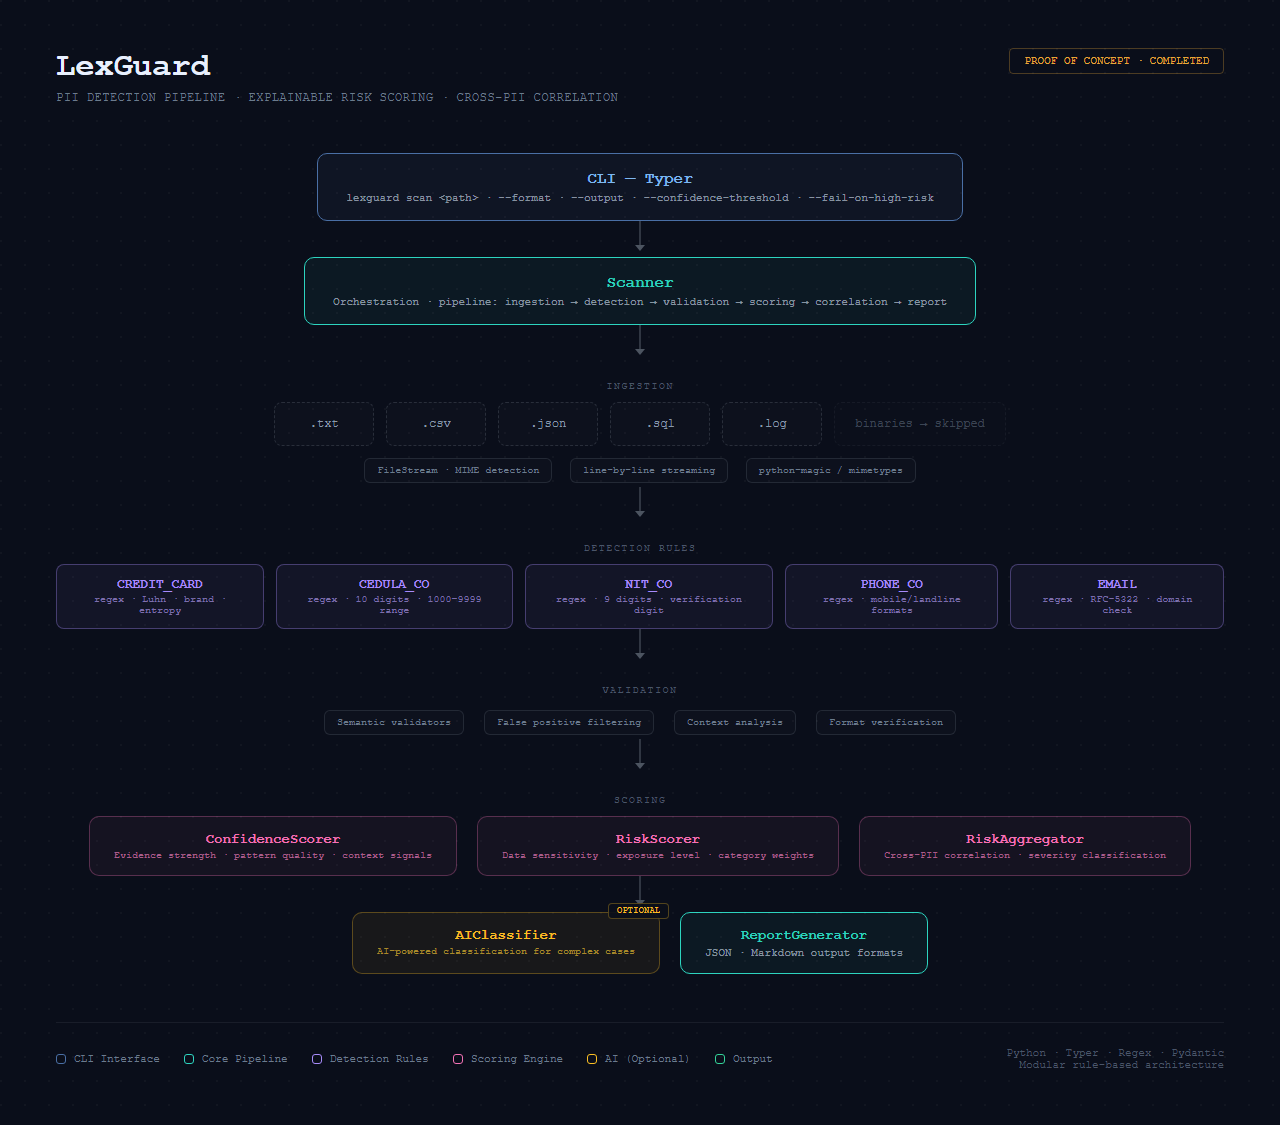
LexGuard procesa archivos de texto mediante un pipeline de análisis compuesto por:
- Ingesta del contenido.
- Aplicación de reglas de detección.
- Identificación de posibles coincidencias.
- Procesamiento de los resultados.
- Generación de una salida estructurada.
La arquitectura separa el procesamiento de entrada de los mecanismos de detección, permitiendo incorporar nuevas reglas sin modificar completamente el flujo de análisis.
4. Arquitectura
El sistema sigue un flujo determinista:
Input
  │
  ▼
Ingestion
  │
  ▼
Detection Rules
  │
  ▼
Matches
  │
  ▼
Analysis
  │
  ▼
Structured Output
Detección
Las reglas analizan el contenido buscando patrones asociados con posibles datos personales.
Separación de responsabilidades
La lógica de detección se mantiene separada del procesamiento de entrada, permitiendo ampliar el conjunto de reglas sin convertir el pipeline en una única implementación monolítica.
Naturaleza determinista
La misma entrada y el mismo conjunto de reglas producen resultados reproducibles, facilitando la inspección y depuración del comportamiento del sistema.
5. Stack Tecnológico
| Tecnología | Propósito |
|---|---|
| Python | Implementación del pipeline y lógica de detección |
El proyecto mantiene deliberadamente un stack pequeño porque su objetivo principal es validar el enfoque de detección y la separación de responsabilidades, no construir todavía una plataforma completa.
6. Funcionalidades Implementadas
- Procesamiento de archivos de texto.
- Detección de posibles datos personales mediante patrones.
- Reglas de detección extensibles.
- Procesamiento determinista.
- Resultados estructurados.
- Separación entre ingesta y detección.
- Interfaz de línea de comandos.
- Flujo preparado para incorporar nuevas categorías de detección.
7. Decisiones Técnicas
Detección basada en reglas
Se utiliza detección mediante patrones predefinidos en lugar de modelos de machine learning.
Ventaja: comportamiento determinista, interpretable y sencillo de depurar.
Trade-off: no permite identificar de forma fiable información que depende del contexto o que no coincide con los patrones definidos.
Arquitectura extensible
Las reglas de detección se mantienen separadas del flujo principal de procesamiento.
Ventaja: permite incorporar nuevos detectores sin rediseñar todo el pipeline.
Trade-off: cada nueva categoría requiere definir y mantener reglas específicas.
Python como lenguaje de implementación
Python permite desarrollar rápidamente el prototipo y mantener una implementación sencilla.
Ventaja: bajo coste de experimentación y amplio ecosistema para procesamiento de texto.
Trade-off: el proyecto no incorpora actualmente las optimizaciones, pruebas y controles necesarios para justificar su uso como servicio de detección de alto volumen.
8. Seguridad y Privacidad
LexGuard debe considerarse una herramienta de detección, no de protección.
El sistema identifica posibles coincidencias de información personal, pero no garantiza que todos los datos personales sean detectados ni que cada coincidencia corresponda realmente a información personal.
Por esta razón:
- Los resultados pueden contener falsos positivos.
- Pueden existir falsos negativos.
- Las reglas no proporcionan comprensión contextual.
- Los resultados requieren validación antes de utilizarse para tomar decisiones de privacidad o cumplimiento.
- El proyecto no implementa almacenamiento, anonimización ni eliminación automática de datos detectados.
La principal consideración de seguridad es evitar interpretar el resultado del detector como una garantía de cobertura completa.
9. Testing y Calidad
El estado actual del proyecto no incluye una infraestructura automatizada de calidad.
Actualmente:
- No existe una suite automatizada de tests.
- No existe pipeline CI/CD.
- No existe linting automatizado.
- No existe type checking automatizado.
Por tratarse de un POC, estas capacidades quedaron fuera del alcance inicial.
Para convertir el proyecto en una herramienta mantenible sería necesario incorporar pruebas sobre cada regla de detección, casos límite y casos diseñados para medir falsos positivos y falsos negativos.
10. Flujo de Uso
LexGuard está diseñado como una herramienta de línea de comandos.
El flujo conceptual es:
Archivo de texto
      │
      ▼
LexGuard
      │
      ├── Reglas de detección
      │
      ▼
Coincidencias encontradas
      │
      ▼
Resultado estructurado
No existe actualmente una interfaz web ni un backend asociado.
11. Estado y Limitaciones
Clasificación: Proof of Concept — Completado
LexGuard se considera un POC finalizado y no se presenta como un producto de producción.
Sus principales limitaciones son:
- Cobertura limitada de categorías de PII.
- Dependencia de patrones predefinidos.
- Ausencia de análisis contextual.
- Posibles falsos positivos y falsos negativos.
- Sin pruebas automatizadas.
- Sin CI/CD.
- Sin API REST.
- Sin interfaz web.
- Sin anonimización o remediación automática.
- Sin garantías de cobertura para escenarios regulatorios.
Estas limitaciones son parte importante del resultado del proyecto: muestran dónde un enfoque determinista deja de ser suficiente y dónde sería necesario introducir técnicas adicionales.
12. Evolución y Qué Demuestra
Una evolución razonable del proyecto sería:
- Ampliar las categorías de detección.
- Incorporar tests específicos para cada regla.
- Medir falsos positivos y falsos negativos.
- Añadir validación contextual mediante NLP.
- Incorporar soporte para JSON y CSV.
- Añadir salidas JSON, CSV y HTML.
- Exponer el análisis mediante una API REST.
- Incorporar mecanismos de anonimización o redacción.
- Añadir CI/CD y controles automatizados de calidad.
Qué demuestra
LexGuard demuestra:
- Automatización de análisis relacionado con privacidad.
- Procesamiento programático de texto.
- Diseño de reglas deterministas.
- Arquitectura extensible.
- Separación de responsabilidades.
- Identificación de las limitaciones de los enfoques basados únicamente en patrones.
- Desarrollo de herramientas de seguridad y privacidad con Python.
El principal valor técnico del proyecto no está en la complejidad de su implementación, sino en demostrar que el problema fue descompuesto en un pipeline reproducible y extensible, identificando también las limitaciones del enfoque elegido.